


我合作过的企业几乎都有这样一套系统:“能用,但没人敢动”。它是十几年前开发的,支撑着开票、库存或日常运营,任何一个小改动都可能让团队紧张一整周。他们问我的往往不是技术问题,而是:现在投入改造值不值得,还是可以再撑一年?
在开发、集成和维护企业系统的 20 多年里,我的回答几乎从来不是“全部重写”,也不是“维持现状”。真正有用的是读懂信号,弄清楚继续等待意味着承担什么风险,然后选择一条不让业务停摆的路径。下面说说我是怎么评估的。
系统需要现代化的信号
单独一个信号并不足以决定改造。关键在于信号叠加了多少,以及它们离核心业务有多近。下面是我最先检查的五项。
版本已停止支持
如果应用还运行在 PHP 5.6 或 7.x、已过 LTS 周期的 Node.js、无人维护的框架或不再打补丁的操作系统上,它就收不到安全修复了。PHP 7.4 在 2022 年底结束官方支持,更早的版本停得更早。问题不只是漏洞:新的依赖库不再兼容,主机服务商下架这些版本,而任何现代集成(支付网关、云服务 SDK)都要求一个你的系统无法使用的运行时。
安全债务
安全债务藏在细节里:密码用不加盐的 MD5 或 SHA-1 存储、SQL 语句靠字符串拼接、会话永不过期、凭据硬编码在代码中、没有审计日志。每一项都能单独修复,但它们同时出现时,通常说明系统诞生于另一个时代,逐个打补丁的成本已经高于重建受影响的那一层。
变更成本
这是业务方最能直接感受到的信号。本该一天完成的调整要花两周,因为没人知道还会弄坏什么。没有自动化测试,部署靠手工,每次发版都提心吊胆。当团队开始对合理需求回答“这个做不了”时,系统已经在拖业务决策的后腿。
依赖单个关键人员
如果只有一个人知道佣金怎么算、月结怎么做、某张表为什么存在,那么企业面临的是运营风险,而不只是技术风险。这个人一旦生病、离职或者干脆倦怠,知识也随之消失。这些知识可以找回来,但必须在动代码之前有计划地记录下来。
性能持续下降
报表要跑好几分钟,月底界面频繁卡死,数据库不断膨胀却没有合适的索引和归档。有时性能问题可以靠局部优化解决:加索引、加缓存、重写查询。但如果架构本身要求一切同步处理,或者只能跑在一台无法扩展的服务器上,那瓶颈就是结构性的。
原地不动的风险
维护遗留系统并不因为没出现在预算表上就不花钱。它的成本分散、隐蔽,而且往往随时间增长:
- 安全事件:停止支持版本中的已知漏洞,是攻击者最容易利用的入口。
- 意外停机:老服务器出故障时可能找不到兼容的替代品,恢复工作一拖就是好几天。
- 错失机会:接入支付、WhatsApp 渠道、电商或人工智能变得昂贵甚至无法实现。
- 人才:愿意并且能够维护老技术的人越来越难找。
- 合规:审计机构、银行和企业客户要求的控制措施,系统拿不出证明。
改造还是替换?
并不是所有老系统都该改造。有时正确的做法是换成市面上的成熟产品;有时则是重建一部分、保留其余部分。我主要看两个维度:系统承载了多少独有的业务价值,以及它的技术基础是否健康。定制很少的通用 ERP 可以替换;而沉淀了多年自有业务规则的系统,几乎永远不该一扔了之。
| 情况 | 我通常建议的路径 | 原因 |
|---|---|---|
| 代码尚可,但运行在已停止支持的版本上 | 升级平台(运行时、框架、服务器) | 风险在基础设施,而不在业务逻辑 |
| 有独特且重要的业务规则,代码难以维护 | 按模块渐进式现代化 | 保留业务知识,每一步都降低风险 |
| 标准流程(会计、薪资),定制很少 | 替换为现成产品并做好集成 | 重复造轮子没有竞争优势 |
| 系统稳定、几乎不变更、不暴露在公网 | 维持并隔离,配合监控和备份 | 几乎不改动的系统,改造投入难以回本 |
| 某个具体环节性能不足 | 拆出该模块或针对性优化 | 问题是局部的 |
| 没人看得懂系统,数据也不可靠 | 先审计、先文档化 | 没有诊断,任何决定都是赌博 |
从零开始全部重写是最让人兴奋的选项,也是我见过失败最多的选项。在长达数月的时间里,业务仍然依赖旧系统,而旧系统本身也在不断变更;新系统追逐的是一个移动的目标,最后才发现有一批从来没人写下来的规则。
渐进式路线:绞杀者模式
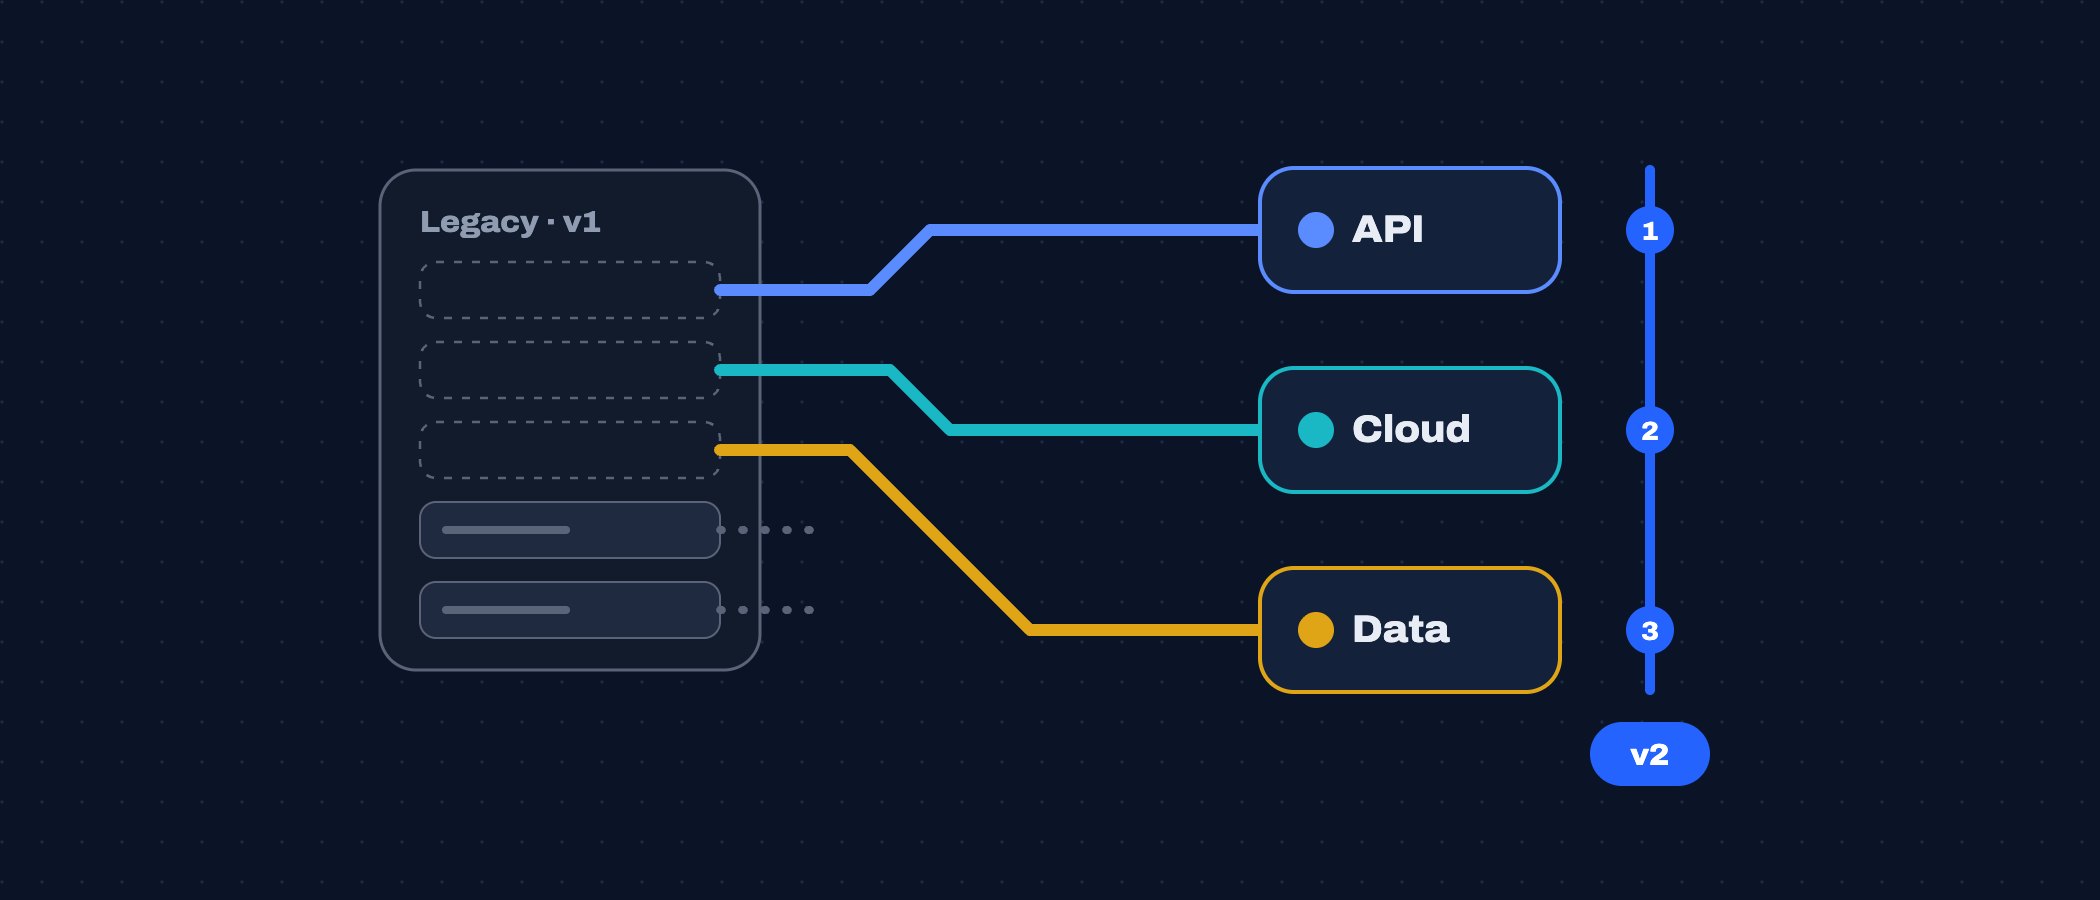
绞杀者模式(Strangler Fig)由 Martin Fowler 提出,做法是在旧系统外围构建新系统,逐步把功能迁移过去,直到旧系统不再承接任何流量。关键组件是一层门面:代理、API 网关或路由层,按路由逐条决定由哪个系统处理请求。
# Nginx 门面:已迁移的路由交给新服务,其余仍由旧系统处理
location /api/invoices/ {
    proxy_pass http://invoicing-new:8080;
}

location / {
    proxy_pass http://legacy-app:80;
}这样每个迁移完成的模块都可以单独上线;出了问题,只需改一条路由就能回退,而不是恢复整套系统。我会把门面和功能开关(feature flag)结合使用,先对内部用户或一部分流量开放新模块。最终用户感受不到一场“大迁移”,只会觉得系统越来越好用。
保住业务规则和数据
遗留系统真正的价值不在代码本身,而在代码所执行的规则:税额如何取整,哪些折扣可以叠加,结账后作废的发票如何处理。很多规则在其他任何地方都没有记录。迁移一个模块之前,我会做三件事:
- 特征测试:把系统当前的行为原样记录下来,哪怕看起来不对,以便发现新系统中的任何差异。
- 规则清单:与业务人员共同审阅的文档,解释每一项计算和每一个例外。
- 数据策略:表结构映射、去重清洗;当新旧系统需要并存时,通过变更数据捕获(CDC)或事件进行同步,确保双方都不会使用过期数据。
数据尤其需要谨慎。迁移不是记录复制完就结束,而是数字对上了才算完成:按期间的合计、按客户的余额、按仓库的库存。我会在新旧系统之间做自动对账,数字不一致,这个模块就不算收尾。
分步实施计划
1. 审计
我会审查代码、基础设施、数据库、集成、安全以及部署流程,并与每天使用系统的人沟通。产出是一张地图:模块、依赖、已知风险,以及没人敢碰的区域。
2. 排定优先级
把技术风险和业务影响放在一起权衡。先处理最痛或暴露面最大的部分,而不是最容易或技术上最有趣的部分。交付拆小,每一次交付都有独立价值。
3. 稳定现状
迁移之前,先让现有系统不再脆弱:经过验证的备份、版本控制、测试环境、错误监控、紧急安全补丁,以及可重复的部署流程。仅这一阶段通常就能减少事故,也为后续工作腾出空间。
4. 按模块迁移
门面就位后,每次只拆出一个模块:它的逻辑、数据和集成。第一个模块我会选边界清晰、影响可控的,先验证方法,再去碰核心。
5. 验证
每个模块都要通过特征测试和数据对账;风险较高时,还会安排一段并行运行期:两套系统处理同样的业务,我对比结果后才关闭旧系统。业务人员用真实案例验收,而不是看演示。
6. 持续演进
现代化不会随着最后一次迁移而结束。目标是让系统具备安全变更的能力:自动化测试、CI/CD、持续更新的文档,以及定期升级的依赖。这样它不会在五年后再次变成遗留系统。
本周就可以回答的问题
- 我们使用的语言、框架和操作系统是什么版本?还在接收安全补丁吗?
- 今天一个小改动从提出需求到上线需要多久?
- 有几个人真正理解系统的关键流程?
- 未来十二个月业务需要哪些集成,而现在做不到?
- 我们的备份真的做过恢复测试吗?
如果有两个以上的答案让你不安,并不意味着要立刻决定重写,而是需要一次诊断。有了诊断,就可以规划分阶段的现代化改造,成本清晰可见,业务也不必停摆。